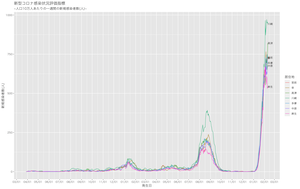
新型コロナ禍、今日現在は、オミクロン株が大流行中。昨年8月ころのピークの3倍の波だが、今週くらいから高原状態になってきた気がする。どうか、このままピークアウトを迎えてほしい。
この波、医療機関に与えている負荷は、相当なものだろう。医療に従事している人たちの尽力に感謝。原因はわからないが、重篤な患者は少ないこと、治療方法が確立し、手探りからは脱していることが、いい傾向。
毎日、自分で、自治体が発表するPDFをダウンロードし、編集し、確認する毎日。今年1月からは、いままでのやり方が通用しなくなってきた。データ数の急増に、手作業が多いこれまでのプロセスは太刀打ちできなくなった。データ規模に応じプロセスを変更しなければいけない。
新規感染者数が100件/日レベルまでは、自治体が発表したPDFを、目で読み、手でテキストに打ち込み、集計&可視化用のR-scriptに読み込ませていた。
新規感染者数が1000件/日レベルまでは、自治体が発表したPDFを、GoogleDriveにuploadし、Google DocumentをつかってPDFからデータをテキストに抽出し、抽出したデータをCopy&Pastしてテキストにし、集計&可視化用のR-scriptに読み込ませていた。PDFからテキストデータの抽出をGoogle Documentに任せていた。Google Documentの能力よりも、COpy&Pastできるバッファサイズの限界が先にきた。
今は、新規感染者数が2000件/日のレベル。自治体が発表したPDFを、Downloadし、Pandas/tabulaを使いPDFからのテキスト抽出し、テキストへ編集するまでをスクリプト化、その後、集計&可視化用のR-scriptに読み込ませている。ほぼ、手作業部分がなくなった。
まさに、データ探索型のプロセス。いったい、いつまで、続くのか。
コメントを残す